درس ۵ از ۱۲، بخش ۲: فراخوانی مدلها
اجرای مدل روی کامپیوتر خودتان با Ollama
در این درس
گاهی نمیخواهیم یا نمیتوانیم داده را به سرویس بیرونی بفرستیم: دادهی حساس سازمانی، نبود اینترنت پایدار، یا هزینهی زیاد درخواستهای پرتعداد. در این وضعیت مدل را محلی اجرا میکنیم. Ollama سادهترین راه برای این کار است: مدل را دانلود میکند، روی CPU یا GPU اجرا میکند و یک API در اختیارتان میگذارد.
نوتبوک این درس
نصب و دانلود مدل#
Ollama را از ollama.com برای ویندوز، مک یا لینوکس نصب کنید. بعد از نصب، یک سرویس در پسزمینه اجرا میشود و برنامهی دسکتاپش هم یک محیط چت ساده دارد. در فهرست مدلهای برنامه دو نوع مدل میبینید:
- مدلهایی با علامت ابر: روی سرورهای خود Ollama اجرا میشوند و با ساخت حساب، سهمیهی هفتگی محدودی دارند.
- مدلهایی با علامت دانلود: روی کامپیوتر شما اجرا میشوند. اولین بار که با آنها چت کنید، دانلود میشوند.
راه دقیقتر، استفاده از خط فرمان است. صفحهی هر مدل در سایت Ollama اندازهها و قابلیتهایش را نشان میدهد، مثلاً اینکه تصویر هم میپذیرد یا فقط متن:
ollama pull gemma3:4b # دانلود مدل Gemma 3 با ۴ میلیارد پارامتر
ollama run gemma3:4b # چت در ترمینال
ollama list # فهرست مدلهای دانلودشده با شناسه، حجم و زمان آخرین تغییر
بخش بعد از : برچسب (tag) مدل است و معمولاً اندازهاش را نشان میدهد: gemma3:1b، gemma3:4b، gemma3:12b. هر چه بزرگتر، باهوشتر و سنگینتر.
اگر دانلود ممکن نبود
اگر دسترسی به سرور Ollama محدود است، فایل مدلها را میشود از جای دیگری گرفت و در پوشهی مدلهای Ollama کپی کرد. بعد از کپی، ollama list آنها را نشان میدهد.
مدلهای کوچک و تخصصی#
مرز دقیقی وجود ندارد، اما معمولاً به مدلهای زیر دو یا سه میلیارد پارامتر مدل زبانی کوچک یا SLM (Small Language Model) میگویند. این مدلها برای سه کار ساخته میشوند:
- اجرا روی دستگاههای ارزان: گوشی، لپتاپ معمولی و حتی خود مرورگر. Chrome و Edge مدل کوچکی دارند که بدون اینترنت جواب میدهد.
- تقطیر دانش (distillation): دانش یک مدل بزرگ به یک مدل کوچک منتقل میشود.
- تخصصی شدن: مدل کوچک روی یک کار خاص fine-tune میشود و در همان کار با مدلهای خیلی بزرگتر رقابت میکند. چند نمونه از خانوادهی Gemma:
| مدل | کاربرد |
|---|---|
| MedGemma | پزشکی |
| TranslateGemma | ترجمه؛ نسخهی ۴ میلیاردیاش ترجمهی خوبی تحویل میدهد (در درس ۱۰ امتحانش میکنیم) |
| FunctionGemma | فراخوانی تابع و ابزار |
مدلهای کوچک معمولاً بیشتر روی انگلیسی آموزش دیدهاند. فارسی را میفهمند، اما خطایشان در فارسی بیشتر است.
فراخوانی از پایتون#
pip install ollama
import ollama
# حالت ساده: یک پرامپت، یک جواب
response = ollama.generate(model="gemma3:4b", prompt="چرا آسمان آبی است")
print(response["response"])
# حالت چت: لیستی از پیامها
response = ollama.chat(
model="gemma3:4b",
messages=[{"role": "user", "content": "پایتخت ایران کجاست؟"}],
)
print(response["message"]["content"])
پایتخت ایران شهر تهران است.
پاسخ chat علاوه بر message اطلاعاتی مثل نام مدل و زمان پردازش (total_duration) هم دارد. message خودش دو بخش دارد: role (اینجا assistant) و content که متن جواب است.
فرستادن تصویر#
Gemma 3 از نسخهی ۴ میلیاردی به بالا چندوجهی (multimodal) است و تصویر هم میپذیرد. کافی است مسیر تصویر را در کلید images بگذارید:
response = ollama.chat(
    model="gemma3:4b",
    messages=[{
        "role": "user",
        "content": "پسورد در این کاغذ چیست؟",
        "images": ["images/password.jpg"],
    }],
)
print(response["message"]["content"])
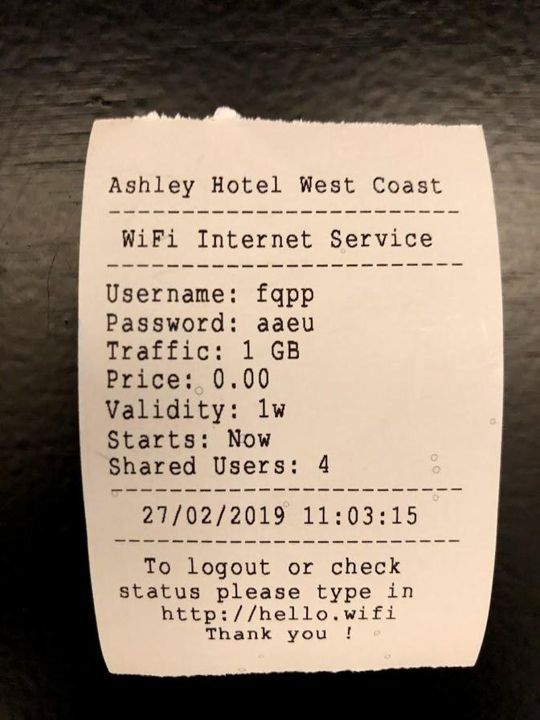
پسورد در این کاغذ aaeu است.
جواب درست است. حالا تصویر یک بنای معروف را بدهیم:
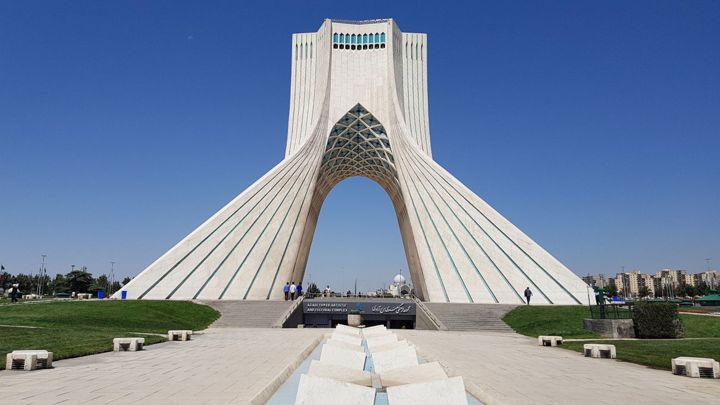
* **ساختمان:** تصویر یک ساختمان مشهور به نام "طلایهآباد" در شهر تهران، ایران است. …
مدل فهمیده که بنا در تهران است، اما اسمش را از خودش ساخته است. این برج آزادی است. نمونهی خوبی از توهم (hallucination) در مدلهای کوچک است: جواب با اعتمادبهنفس و ظاهر درست، اما غلط. هر چه مدل کوچکتر باشد، دانش کمتری را در خودش جا داده و احتمال چنین خطایی بیشتر است. در درس ۸ راههای کم کردن توهم را میبینیم.
REST API: بدون کتابخانه و از هر زبانی#
سرویس Ollama بهطور پیشفرض روی http://localhost:11434 اجرا میشود. هر برنامهای که بتواند درخواست HTTP بفرستد، میتواند از آن استفاده کند و به پایتون محدود نیستید:
import requests

res = requests.post("http://localhost:11434/api/chat", json={
    "model": "gemma3:4b",
    "stream": False,
    "messages": [{"role": "user", "content": "سلام!"}],
})
print(res.json()["message"]["content"])
پاسخ استریمی#
اگر stream را False نکنید، Ollama جواب را توکنبهتوکن میفرستد. این همان تولید خودبازگشتی درس ۲ است. نتیجه این است که کاربر مجبور نیست تا تولید آخرین توکن صبر کند و متن را همزمان با تولید میبیند، همانطور که در ChatGPT میبینید:
import json, requests

data = {"model": "gemma3:4b",
        "messages": [{"role": "user", "content": "create a complete blog post about VLM (Vision Language Model)"}]}

full_response = ""
with requests.post("http://localhost:11434/api/chat", json=data, stream=True) as r:
    for line in r.iter_lines():
        if line:
            chunk = json.loads(line)                  # هر خط یک JSON کوچک است
            content = chunk["message"]["content"]
            full_response += content
            print(content, end="", flush=True)        # بدون رفتن به خط بعد
flush=True باعث میشود هر تکه همان لحظه چاپ شود و در بافر نماند. در پایان، full_response کل متن را دارد و میشود آن را با Markdown(full_response) در نوتبوک قالببندیشده نمایش داد.
Ollama هم OpenAI-compatible است
Ollama یک API سازگار با OpenAI هم روی http://localhost:11434/v1 دارد. یعنی کتابخانهی openai درس قبل با base_url="http://localhost:11434/v1" و یک کلید دلخواه به مدل محلی شما وصل میشود.
خلاصه#
- Ollama مدلهای باز را دانلود و اجرا میکند:
ollama pull،ollama runوollama list. - از پایتون با
ollama.chatوollama.generate، و از هر زبانی با REST API روی پورت ۱۱۴۳۴ میشود به آن وصل شد. - مدلهای چندوجهی تصویر هم میگیرند، اما مدلهای کوچک بیشتر دچار توهم میشوند.
- استریم کردن پاسخ تجربهی کاربر را خیلی بهتر میکند.