درس ۶ از ۱۲، بخش ۲: فراخوانی مدلها
LiteLLM: یک رابط برای همهی مدلها، و دو برنامه با Streamlit
تا اینجا برای هر سرویس کد جداگانهای نوشتیم: client.responses.create برای GapGPT و ollama.chat برای مدل محلی. هر کدام ورودی و خروجی خودش را دارد. اگر بخواهید در یک پروژه مدل را عوض کنید، یا یک کار را با چند مدل مقایسه کنید، باید کد را بازنویسی کنید.
LiteLLM این مشکل را حل میکند: یک تابع completion با یک قالب ورودی و یک قالب خروجی، برای بیش از صد ارائهدهنده. از اینجا تا آخر بخش پرامپتنویسی، همهی کدها با LiteLLM نوشته میشوند.
کدهای این درس
02_04_litellm.ipynb، 02_05_Gemma_simple_UI.py و 02_06_Chat_with_PDF_using_Ollama_LLM.py
نصب#
pip install litellm
# اگر دسترسی به PyPI محدود است، از یک آینهی داخلی:
pip install -i https://mirror-pypi.runflare.com/simple litellm
completion: یک تابع برای همه#
from litellm import completion
from dotenv import load_dotenv
load_dotenv() # کلیدها و آدرسها از .env (درس ۴)
response = completion(
model="ollama/gemma3:4b",
messages=[{"role": "user", "content": "پایتخت ایران کجاست؟"}],
)
print(response["choices"][0]["message"]["content"])
پایتخت ایران شهر **تهران** است.
پیشوند نام مدل مسیر درخواست را تعیین میکند:
| نام مدل | درخواست کجا میرود؟ |
|---|---|
ollama/gemma3:4b |
Ollama محلی (پیشفرض localhost:11434؛ با OLLAMA_API_BASE قابل تغییر) |
openai/gpt-5.2 |
سرویس سازگار با OpenAI که در OPENAI_API_BASE تعریف کردهاید |
openai/claude-sonnet-4-6 |
همان مسیر قبلی. openai/ یعنی «پروتکل OpenAI»، نه «شرکت OpenAI». GapGPT مدل Claude را با همین پروتکل سرو میکند |
anthropic/…، gemini/… |
مستقیم به API خود آن شرکتها (با کلید جداگانه) |
برای مقایسه، یک سؤال را از چهار مدل بپرسیم. فقط یک رشته عوض میشود:
for model in ["ollama/llama3.1:8b", "ollama/gemma3:4b", "openai/gpt-5.2", "openai/claude-sonnet-4-6"]:
    r = completion(model=model, messages=[{"role": "user", "content": "تو کی هستی؟"}])
    print(model, "→", r["choices"][0]["message"]["content"][:120])
خلاصهی جوابها:
- Llama 3.1 8B: «من یک هوش مصنوعی هستم، از یک شرکت داده کاوی …». این جواب درست نیست؛ Llama را Meta ساخته است.
- Gemma 3 4B: «من یک مدل زبان بزرگ هستم که توسط گوگل آموزش داده شدهام.»
- GPT-5.2: «من یک دستیار هوش مصنوعی هستم (مدل زبانیِ OpenAI) …»
- Claude: «من یک هوش مصنوعی هستم که توسط Anthropic ساخته شدهام و نامم Claude است.»
ساختار پاسخ#
LiteLLM پاسخ همهی ارائهدهندهها را به قالب OpenAI درمیآورد:
import json
print(json.dumps(response.model_dump(), indent=2, ensure_ascii=False))
{
"model": "ollama/gemma3:4b",
"choices": [
{
"finish_reason": "stop",
"index": 0,
"message": {"role": "assistant", "content": "سلام! چطوری؟ چه کمکی از من میخوای؟ 😊\n"}
}
],
"usage": {"prompt_tokens": …, "completion_tokens": …, "total_tokens": …}
}
choicesیک لیست است، چون میشود چند جواب همزمان خواست. معمولاً خانهی صفرم را برمیداریم.finish_reasonدلیل توقف تولید است:stopیعنی توکن پایان تولید شده وlengthیعنی به سقف توکن رسیدهایم. اگرlengthدیدید، جواب احتمالاً ناقص است.usageتعداد توکنهای مصرفشده است و برای حساب هزینه به کار میآید.
استریم#
response = completion(
    model="ollama/gemma3:4b",
    messages=[{"role": "user", "content": "یک پاراگراف در مورد ایران بنویس"}],
    stream=True,
)
for chunk in response:
    delta = chunk["choices"][0].get("delta", {}).get("content")
    if delta:
        print(delta, end="", flush=True)
در حالت استریم، هر chunk بهجای message یک delta دارد که فقط تکهی تازهی متن را در خود دارد.
تصویر#
برای فرستادن تصویر از قالب OpenAI استفاده میکنیم: content بهجای رشته یک لیست است که هم بخش متنی دارد و هم بخش تصویری. تصویر به base64 تبدیل میشود. base64 روشی برای نوشتن هر فایل باینری به شکل یک رشتهی متنی است و با پیشوند data:image/jpeg;base64, فرستاده میشود:
import base64

def encode_image(path):
    with open(path, "rb") as f:
        return base64.b64encode(f.read()).decode("utf-8")

response = completion(
    model="openai/gpt-4o",          # یا "ollama/gemma3:4b" برای مدل محلی
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "یه اسم زیبا برای تصویر زیر بزار"},
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{encode_image('images/image.webp')}"}},
        ],
    }],
)
print(response["choices"][0]["message"]["content"])
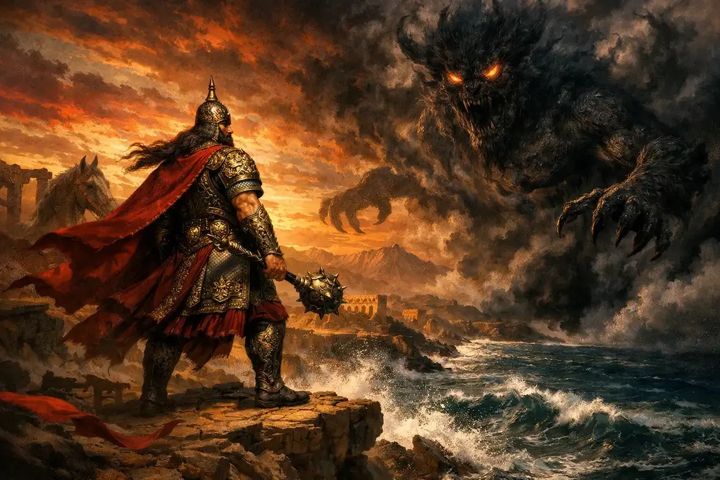
GPT-4o جواب داد «نبرد در برهوت» و در اجراهای دیگر «در برابر سایههای مه» و «نبرد با شبح طوفانی». به خاطر نمونهبرداری، هر بار اسم تازهای میدهد. Gemma 3 4B بهجای یک اسم، فهرستی از پیشنهادها داد. مدلهای کوچک کمتر به قید «فقط یک اسم» پایبندند.
رابط کاربری با Streamlit#
Streamlit با چند خط پایتون یک رابط وب میسازد و برای نمونهی اولیهی برنامههای LLM خیلی رایج است.
یک چت ساده#
# 02_05_Gemma_simple_UI.py
import streamlit as st
from litellm import completion
from dotenv import load_dotenv
load_dotenv()

st.title("Gemma 3 Chat via LiteLLM")
prompt = st.text_area(label="Write your prompt.")
button = st.button("Okay")

if button and prompt:
    response = completion(model="ollama/gemma3:4b", messages=[{"role": "user", "content": prompt}])
    st.markdown(response["choices"][0]["message"]["content"])
pip install streamlit
streamlit run 02_05_Gemma_simple_UI.py
مرورگر روی localhost:8501 باز میشود. Streamlit راستبهچپ را خوب پشتیبانی نمیکند و فارسی کمی بههمریخته نمایش داده میشود، اما کار میکند.
گفتگو با PDF#
حالا یک برنامهی مفیدتر: کاربر یک PDF بارگذاری میکند و از محتوایش سؤال میپرسد. در کلاس با فایل «پرسشوپاسخ بازار سرمایه» امتحانش کردیم.
# 02_06_Chat_with_PDF_using_Ollama_LLM.py (خلاصه)
import fitz # pip install PyMuPDF
def extract_text_from_pdf(uploaded_file):
doc = fitz.open(stream=uploaded_file.read(), filetype="pdf")
return "".join(page.get_text() for page in doc) # فقط متن؛ تصویرها نادیده گرفته میشوند
st.title("Chat with PDF")
uploaded_file = st.file_uploader("Upload your PDF file", type="pdf")
if uploaded_file is not None:
with st.spinner("Extracting text from PDF..."):
pdf_text = extract_text_from_pdf(uploaded_file)
st.success(f"PDF loaded successfully! ({len(pdf_text)} characters)")
prompt = st.text_area("Ask a question based on the PDF content.")
if st.button("Okay") and prompt:
combined_prompt = f"Based on the following content: {pdf_text}\n\nQuestion: {prompt}"
with st.spinner("Generating response..."):
response = completion(model="openai/gpt-5.2",
messages=[{"role": "user", "content": combined_prompt}])
st.markdown(response["choices"][0]["message"]["content"])
به combined_prompt پرامپت افزوده (augmented prompt) میگویند: سؤال کاربر بهتنهایی به مدل نمیرود و محتوای سند هم به آن اضافه میشود. st.spinner هم یک نشانگر «در حال پردازش» نشان میدهد تا کاربر بداند برنامه کار میکند.
این برنامه سه محدودیت مهم دارد که در دورههای بعد حلشان میکنیم:
- کل PDF در هر سؤال فرستاده میشود. برای یک سند چندصدصفحهای هم گران است و هم از پنجرهی کانتکست بیرون میزند. راهحل این است که فقط تکههای مرتبط پیدا و فرستاده شوند؛ یعنی RAG.
- حافظه ندارد. هر سؤال مستقل فرستاده میشود. اگر بپرسید «ساعت معاملات چهارشنبه چطور است؟» و بعد بگویید «آخر هفته چطور؟»، مدل نمیداند «چطور» یعنی چه. در درس ۱۱ میبینیم حافظه یعنی فرستادن تاریخچهی گفتگو.
- فقط متن. جدولها و تصویرهای PDF از دست میروند.
خلاصه#
- LiteLLM با یک تابع
completionو قالب پاسخ OpenAI، همهی ارائهدهندهها را یکی میکند. پیشوند نام مدل مسیر را تعیین میکند. finish_reasonوusageرا در پاسخ چک کنید.- استریم با
stream=Trueو خواندنdelta، و تصویر با محتوای چندبخشی و base64 انجام میشود. - با Streamlit میشود در چند دقیقه یک نمونهی اولیه ساخت. «گفتگو با PDF» اولین قدم به سمت RAG است.