درس ۷ از ۷، حافظه و چندوجهی
پیامهای چندوجهی: فرستادن تصویر به مدل
در این درس
مدلهای چندوجهی (multimodal) علاوه بر متن، ورودیهای دیگری مثل تصویر و گاهی صدا یا فایل را هم میپذیرند. به هر نوع ورودی یک وجه (modality) میگویند. در دورهی اول با Ollama و LiteLLM تصویر فرستادیم. در LangChain هم ایده همان است: content پیام بهجای یک رشته، لیستی از بخشها است و هر بخش نوع خودش را دارد.
نوتبوک این درس
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage

llm = init_chat_model("gpt-4o-mini", model_provider="openai", temperature=0)   # باید مدلی باشد که تصویر بپذیرد
۱. تصویر با URL#
سادهترین روش: آدرس عمومی تصویر را مستقیم بدهید. سرور ارائهدهنده خودش تصویر را دانلود میکند.
message = HumanMessage(content=[
    {"type": "image_url",
     "image_url": {"url": "https://upload.wikimedia.org/wikipedia/commons/2/23/Azadi_Tower_%2829358497718%29.jpg"}},
    {"type": "text", "text": "این تصویر را توصیف کن. به فارسی پاسخ بده."},
])
print(llm.invoke([message]).content)
این تصویر نمایی از برج آزادی در تهران را نشان میدهد. برج آزادی با طراحی خاص و منحصر به فرد خود، یکی از نمادهای مهم و شناختهشده ایران است. …
در دورهی اول، Gemma 3 4B همین بنا را «طلایهآباد» نامیده بود. یک مدل بزرگتر آن را درست میشناسد.
۲. تصویر با base64#
اگر تصویر آدرس عمومی ندارد یا سرور ارائهدهنده به آن دسترسی ندارد، خود تصویر را میفرستیم. base64 روشی استاندارد برای تبدیل هر دادهی دودویی (تصویر، PDF، صدا) به یک رشتهی متنی است. با آن میشود تصویر را در JSON فرستاد یا در پایگاه داده ذخیره کرد و طرف مقابل، در هر زبانی، آن را دوباره به فایل برمیگرداند.
import base64, io, requests
from PIL import Image
def url_to_base64(url: str) -> tuple[str, str]:
response = requests.get(url, headers={"User-Agent": "Mozilla/5.0"}, timeout=20)
response.raise_for_status()
img = Image.open(io.BytesIO(response.content))
img.verify() # مطمئن شو واقعاً تصویر است
media_type = f"image/{img.format.lower()}" # مثلاً image/jpeg
return base64.b64encode(response.content).decode("utf-8"), media_type
image_data, media_type = url_to_base64(image_url)
print(media_type, len(image_data)) # image/jpeg 2428212
message = HumanMessage(content=[
{"type": "image_url", "image_url": {"url": f"data:{media_type};base64,{image_data}"}},
{"type": "text", "text": "چه ساختمانها یا مکانهایی در این تصویر میبینی؟"},
])
User-Agentرا میگذاریم چون بعضی سایتها درخواستهای بدون مرورگر را رد میکنند.img.verify()مطمئن میشود چیزی که دانلود شده واقعاً تصویر است، نه یک صفحهی خطای HTML.- قالب
data:<نوع>;base64,<داده>همان data URL است که مرورگرها هم میفهمند. - رشتهی base64 حدود یکسوم از خود فایل بزرگتر است. پیش از فرستادن، تصویرهای بزرگ را کوچک کنید. هم توکن کمتری مصرف میکند و هم سریعتر است.
از فایل محلی#
import mimetypes

def image_file_to_base64(file_path: str) -> tuple[str, str]:
    media_type, _ = mimetypes.guess_type(file_path)   # از روی پسوند: image/jpeg، image/png، …
    with open(file_path, "rb") as f:
        return base64.b64encode(f.read()).decode("utf-8"), media_type or "image/jpeg"

def analyze_image(file_path: str, question: str) -> str:
    data, media_type = image_file_to_base64(file_path)
    message = HumanMessage(content=[
        {"type": "image_url", "image_url": {"url": f"data:{media_type};base64,{data}"}},
        {"type": "text", "text": question},
    ])
    return llm.invoke([message]).content

print(analyze_image("images/password.jpg", "متن روی این رسید را بخوان و پسورد را بگو"))
متن روی رسید به شرح زیر است:
- Username: fqpp
- Password: aaeu

پسورد: **aaeu**
این همان کاری است که در OCR سنتی چند مرحله داشت: خواندن متن، پیدا کردن بخش مربوط و استخراج مقدار.
۳. چند تصویر در یک پیام#
بخشهای متنی و تصویری را میشود به هر ترتیبی کنار هم گذاشت. متنهای میانی به مدل میگویند هر تصویر چیست:
tehran_data, tehran_type = image_file_to_base64("images/Azadi.jpg")
isfahan_data, isfahan_type = image_file_to_base64("images/isfahan.jpg")
message = HumanMessage(content=[
{"type": "text", "text": "این تصویر اول مربوط به تهران است:"},
{"type": "image_url", "image_url": {"url": f"data:{tehran_type};base64,{tehran_data}"}},
{"type": "text", "text": "این تصویر دوم مربوط به اصفهان است:"},
{"type": "image_url", "image_url": {"url": f"data:{isfahan_type};base64,{isfahan_data}"}},
{"type": "text", "text": "این دو تصویر را مقایسه کن و تفاوتهای معماری، بافت شهری و فضای فرهنگی را "
"در ۴ جمله به صورت bullet point فارسی توضیح بده."},
])
print(llm.invoke([message]).content)
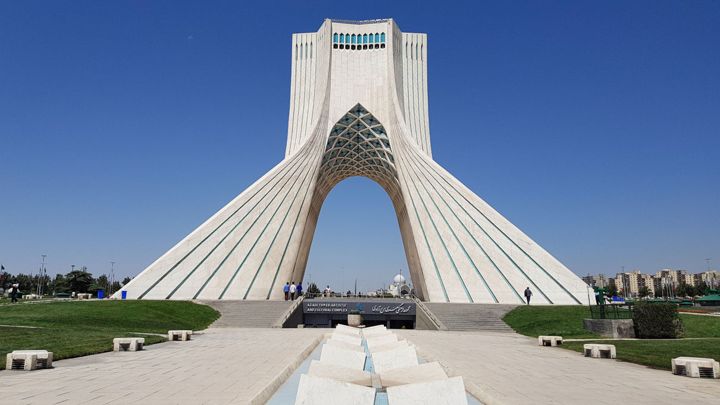
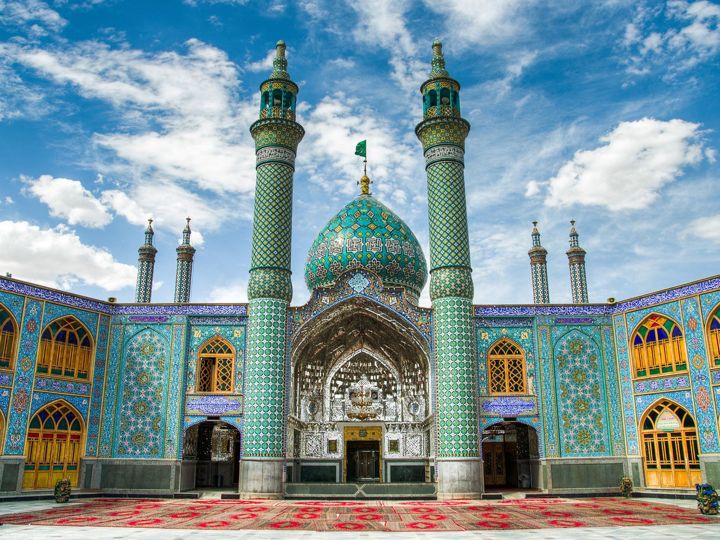
- معماری: تصویر اول نمایی از برج آزادی در تهران را نشان میدهد که با طراحی مدرن و خطوط هندسی مشخص میشود، در حالی که تصویر دوم نمایی از مسجدی در اصفهان است که با کاشیکاریهای رنگارنگ و جزئیات تزئینی سنتی شناخته میشود.
- بافت شهری: تهران به عنوان پایتخت، با ساختمانهای بلند و مدرن …
کاربردهای مشابه: مقایسهی دو نسخه از یک طراحی، بررسی عکس قبل و بعد از تعمیر، یا خواندن چند صفحهی اسکنشده با هم.
۴. نگاهی به جلو: ایجنتی که تصویر تحلیل میکند#
در نوتبوک، تحلیل تصویر به یک ابزار تبدیل شده و به یک ایجنت داده شده است:
from langchain.agents import create_agent
from langchain.tools import tool
@tool
def analyze_image_from_url(url_and_question: str) -> str:
"""تصویر را از URL دریافت کرده و تحلیل میکند. ورودی باید به شکل 'URL|||سوال' باشد."""
url, question = url_and_question.split("|||", 1)
message = HumanMessage(content=[{"type": "image_url", "image_url": {"url": url.strip()}},
{"type": "text", "text": question.strip()}])
return llm.invoke([message]).content
vision_agent = create_agent(model=llm, tools=[analyze_image_from_url],
system_prompt="شما یک دستیار تحلیل تصویر هستید. برای تحلیل تصاویر از ابزار analyze_image_from_url استفاده کنید.")
- برای «پایتخت ایران کجاست؟» ایجنت ابزار را صدا نزد و مستقیم جواب داد: «پایتخت ایران، تهران است.»
- برای «این تصویر از تهران را تحلیل کن: https://…» ابزار را با URL و سؤال صدا زد و نتیجه را به زبان طبیعی برگرداند.
تصمیم اینکه کی ابزار لازم است، با خود مدل است. این همان چیزی است که یک ایجنت را از یک زنجیرهی ثابت جدا میکند. ابزارها، ایجنتها و الگوهای طراحی ایجنتی موضوع دورهی بعد است.
خلاصه#
- محتوای چندوجهی یعنی
contentلیستی از بخشهاست:{"type": "text", …}و{"type": "image_url", …}. - تصویر را با URL عمومی یا به شکل data URL با base64 بفرستید. پیش از فرستادن، تصویر را اعتبارسنجی و کوچک کنید.
- چند تصویر و متن را میشود به هر ترتیبی در یک پیام کنار هم گذاشت.
- با تبدیل تحلیل تصویر به ابزار، ایجنت خودش تصمیم میگیرد کی از آن استفاده کند.